Compositional distributional semantics for modelling natural language
summary
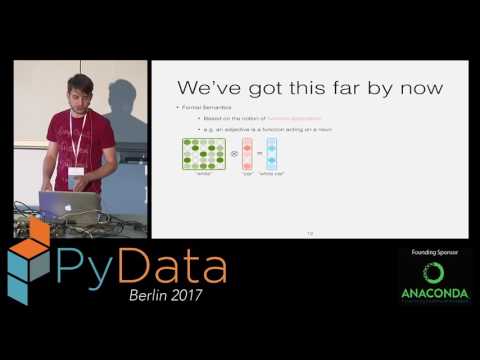
Summarises concrete composition methods and what actually works: compares pointwise addition and multiplication (surprisingly hard to beat), matrix/tensor function application from formal semantics (theoretically principled but intractable to scale), anchored packed dependency trees (parsing Wikipedia into sparse ~2 million‑dimensional count spaces then offsetting to compose), and learned neural composition (task‑specific, often fine‑tuned; translation uses ~1000 dims, common word embeddings use ~300). Notes real applications in aspect‑based sentiment and question answering and that evaluation remains the Achilles heel.
AI-written summary · about
chapters (15)
- 0:00Compositional distributional semantics intro
- 1:06Distributional word representations
- 3:58Why word embeddings powerful
- 6:07Need for composition functions
- 7:12Addition/multiplication limits
- 8:57Formal semantics issues
- 10:43Anchored P&C trees sparsity
- 13:15Neural networks as compositors
- 15:02Evaluating compositors hard
- 17:07Sentence vector meaning
- 19:17Composition and polysemy
- 21:01Sentiment analysis use case
- 23:32Question answering with compositors
- 25:37Limitations and research trends
- 26:50Q&A
related talks
 01h 31mNatural Language Understanding: Foundations and State-of-the-Art
 45mReasoning in Natural Language
 29mCompositional sparsity and learnability
 01h 00mHuman and machine inductive biases for compositional linguistic generalization
 18mCompositional imprecise probability: a solution from graded monads and Markov categories
 38mProgram Synthesis: A Dream Realized?
 49mSemantic Foundations for Probabilistic Programming
 46mContext is all you need: FUNdamental linguistics for NLP