Data Rivers — The New Analytics Architecture

summary
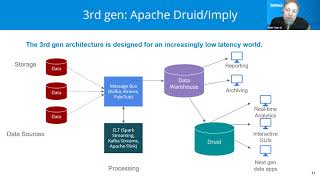
Argues that a Data Rivers architecture pairs streaming (Kafka) and lake storage (Hadoop) into Apache Druid for real-time analytics, with native batch and stream ingest, columnar storage, late materialization, and cloud native microservices. Demonstrates sub-second queries at large scale (used at Yahoo and Netflix), exact group-bys plus count distinct with sketches, linear scaling, and compressed indexes like Roaring and Concise to keep storage and query costs low.
AI-written summary · about
related talks
 28mBest of Stream + Batch: When Streaming Analytics Isn’t
 39mApache Druid 101
 20mAnalyzing streaming data with Apache Druid
 45mModern Data Architecture
 47mExpert Panel: Current & Future State of the Art in Real-Time Data Infrastructure
 38mRealtime Data Activation - Analytics, Intelligence & Decision Making
 31mData Warehouses Meet Data Lakes
 05mThe Future of Data Warehousing