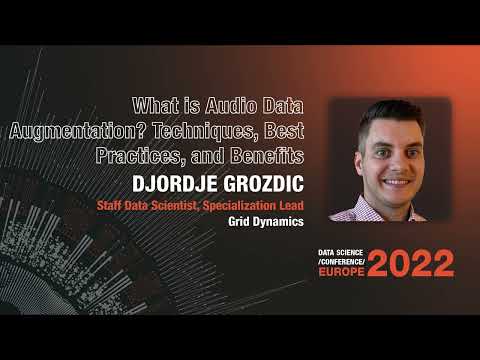
What is Audio Data Augmentation?
summary
Covers concrete augmentations (time shifting by milliseconds, time stretching, pitch scaling to child or deep voices, white‑noise addition, convolutional reverb, low/high/band‑pass filters, polarity inversion, random gain) and spectrogram tricks (time masking, frequency masking). Distinguishes offline vs online and parallel vs sequential pipelines, warns to augment only training data. Recommends tools that actually run these transforms: librosa, audiomentations, torchaudio, pyroomacoustics, reporting that these increase robustness and reduce overfitting in practice.
AI-written summary · about
chapters (16)
- 0:00Intro
- 1:44Why is Audio Data Augmentation Important and What it is?
- 2:31How does data augmentation work?
- 6:35Audio data augmentation approaches
- 8:44Audio data augmentation applications
- 10:34Audio data representations
- 11:16Audio data augmentation types
- 12:02Raw audio augmentation transformation - Time shifting
- 12:51Raw audio augmentation transformation - Time stretching
- 13:26Raw audio augmentation transformation - Pitch scaling
- 14:02Raw audio augmentation transformation - Noise addition
- 17:24Raw audio augmentation transformation - Polarity inversion
- 17:55Raw audio augmentation transformation - Random gain
- 18:40Spectrogram augmentation transformation - Time masking
- 19:35Spectrogram augmentation transformation - Frequency masking
- 20:33Audio data augmentation Libraries in Python
related talks
 25mLooking at Sound
 28mHow to use Deep Learning to process audio data and classify sounds.
 40mGathering Insights from Audio Data
 27mWhat happens when AI starts grocking streaming audio directly
 14mLightning Talk: Enabling the Audio Modality for Language Models
 01h 14mExploring the hidden potential of sound data
 20mExploring the hidden potential of sound data
 22mUbicoustics: Plug-and-Play Acoustic Activity Recognition