Gradient-Descent for Randomized Controllers under Partial Observability
summary
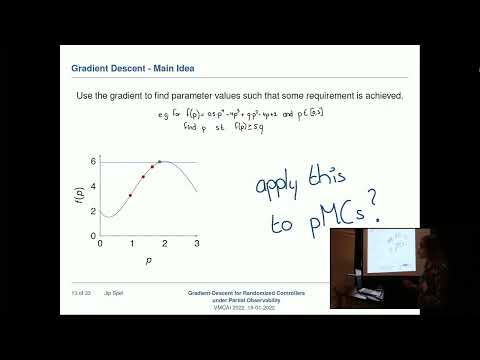
Transforms partially observable controllers into a parametric Markov chain and computes exact derivatives by building a derived weighted automaton so gradients equal expected rewards on that automaton, then applies multiple gradient-descent variants (plain, momentum, Nesterov, adaptive, momentum sign) with minibatch updates (32) and three region-restriction schemes (projection, log-barrier, sigmoid). Projection and momentum-sign win empirically, often beating QCQP and particle-swarm optimization by about an order of magnitude on benchmark POMDP-derived pMCs.
AI-written summary · about
chapters (13)
- 0:00Introduction
- 0:30Partial Observability
- 3:47Parametric Markov Chain
- 8:21GradientDescent
- 12:09GradientDescent Methods
- 13:54Restriction Methods
- 15:26Experimental Validation
- 15:48Model Checker
- 18:22Feasibility Synthesis
- 20:04Particle Swarm Optimization
- 20:33Summary
- 21:08Questions
- 22:42Conclusion
related talks
 45mPolicy Gradient: Optimal Estimation, Convergence, and Generalization beyond Cumulative Rewards
 01h 00mMin-Max Optimization from a Dynamical Systems Viewpoint
 31mLearning to Control Unknown Systems
 35mOn the Global Convergence and Approximation Benefits of Policy Gradient Methods
 55mOptimality and Approximation with Policy Gradient Methods in Markov Decision Processes
 41mCompetitive Algorithms for Online Control
 53mOff-policy Policy Optimization
 42mReinforcement Learning using Generative Models for Continuous State and Action Space Systems