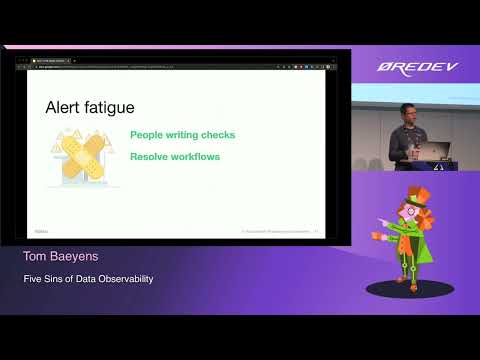
Five Sins of Data Observability
summary
Argues that silent data failures cripple business logic and proposes a pragmatic stack: lightweight ML to spot row‑count and distribution anomalies plus domain soda CL checks authored by engineers, analysts and data owners, embedded as libraries in pipelines or exposed via a self-serve web UI. Recommends managing checks as code, quarantining downstream outputs to quarantine the data, and starting small at the data product and source layers so alerts stay actionable and alert‑fatigue stays under control.
AI-written summary · about
chapters (14)
- 0:00Introduction
- 3:15Optimism in data pipelines
- 6:02Data issues dangers
- 8:55Data quality term
- 11:44Excluding people checks
- 13:10Alert fatigue monitoring
- 15:41Writing data checks
- 16:24Never postpone checks
- 17:48Embedded vs self-serve checks
- 21:20Self-serve data revolution
- 22:25Data contracts and mesh
- 23:51Building data trust
- 25:18Summary and call to action
- 26:36Q&A
related talks
 32mRules of Observability: The Data Edition
 29mData Observability: From 1788 To 2032
 19mObservability for Data Pipelines: Monitoring, Alerting & Tracing Lineage
 13mObservability Where are We Headed?
 32mEssential Software Observability for Every Role: Look No Further
 41mData Observability - System Health to Business Health
 13mObservability that matters
 32mReliability in Finance: Delivering Quality Market Data at Scale