Optimal Observability
summary
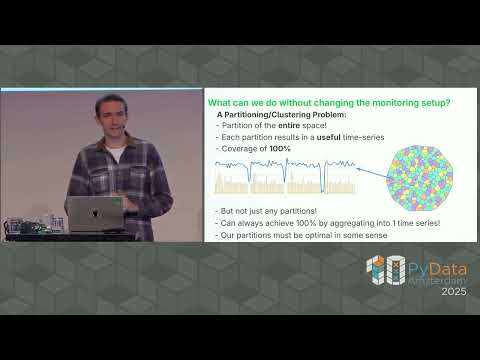
Presents a concrete pipeline: define a BDR/BDP detection metric that accounts for counts, use inverse-harmonic-mean ordering plus moving-window agglomeration and pairwise feature-order flips, implement scalable steps as custom UDFs, and optimize for detection probability. Runs on payment data (about 100M transactions/day), cuts a 7M potential-series space to 7M→50k (configurable to 10k) homogeneous series, yields full coverage and more detected problems despite far fewer series, and notes tradeoffs: delivery complexity, alert duplication, and the need for healthy training data.
AI-written summary · about
chapters (10)
- 0:00Introduction
- 2:32Aggregation in monitoring
- 5:02Fixed partitioning problems
- 11:43Optimal partitioning problem
- 15:59Detection rate optimization
- 23:23Scalable partitioning algorithm
- 27:14Results and benefits
- 30:02Implementation challenges
- 31:27Assumptions and final remarks
- 31:48Q&A
related talks
 01h 21mBuilding a ML Model Observability pipeline
 36mBeyond Sequential: A Recipe for Async Pipeline Observability and Alerting
 32mRules of Observability: The Data Edition
 25mFrom Blind Spots to Total Vision: O11y at Massive Scale
 56mUnwiring High Cardinality
 19mObservability for Data Pipelines: Monitoring, Alerting & Tracing Lineage
 17mObservability in Modern Treasury Trading Platforms
 10mBuilding High-Performance Financial Data Pipelines