Personalizing Explainable Recommendations with Multi-objective Contextual Bandits
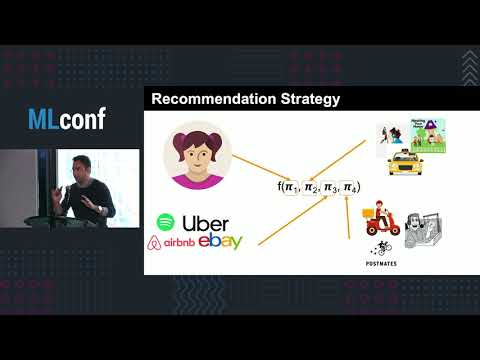
summary
Displays a contextual bandit deployed on Spotify’s homepage serving 100% traffic and trained as a multi-objective linear contextual bandit that optimizes a Gini-based aggregation of vector rewards. Includes theoretical regret bounds, offline experiments showing that jointly optimizing multiple satisfaction metrics improves each one, and live/production tests exploring relevance versus fairness where an extreme fairness policy causes a 35% dip in satisfaction. Uses adaptive policies with user tolerance estimates and reports non–zero-sum gains for business and user metrics.
AI-written summary · about
chapters (7)
- 0:00Introduction to the talk
- 1:31User-centric recommendations
- 4:46Marketplace dynamics
- 8:04Multi-objective optimization
- 9:12Relevance and fairness
- 14:32Multi-objective bandits
- 20:01Conclusion and datasets
related talks
 41mKeynote: Personalization, Bandits, and Causal inference
 32mMulti-Armed Bandits in Recommendations
 20mWinning the Game: Leveraging Contextual Bandits for Creative Optimization
 01h 01mStochastic Bandits: Foundations and Current Perspectives
 27mEnhancing Personalization Using Recommendation Systems & Multi-Armed Bandits
 45mContextual Multi-Arm Bandit and its applications to digital experiments
 21mLeveraging Multi-Armed Bandit Algorithms for Dynamic Decision Making
 39mGrowing user engagement with RL-driven personalisation