Multimodal language models

summary
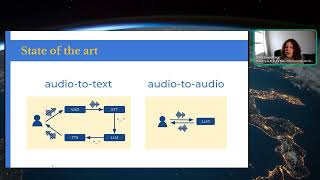
Kyutai presents an open-source weights and code release for a compact multimodal LLM that combines a neural audio codec, a hierarchical generator and multistream modeling to enable true real‑time full‑duplex voice agent behavior. Training uses hundreds of thousands of hours of synthetic, dual‑channel dialogues generated by a high‑fidelity TTS voice‑cloning pipeline. The team quantizes models to run locally on consumer hardware and publishes a detailed 60‑page paper with reproducible technical specifics.
AI-written summary · about
chapters (9)
- 0:00Multimodal language models intro
- 1:26Voice AI limitations
- 4:55Full duplex conversation
- 7:00Text to audio models
- 10:10Compressing audio efficiently
- 13:20Dialogue system with multistream
- 14:46Conversational AI data challenges
- 16:58Synthetic training data
- 19:07Conclusion and voice AI future
related talks
 21mMultimodal Open Source at Kyutai, From Online Demos to On-Device
 22mWhy TTS Models Now Look Like LLMs
 19mLLM-Enhanced Multimodal AI: Revolutionizing Audio/Video Interaction
 04mBeyond Multimodal: Building Full‑Modal AGI Via Open‑Weight
 40mKeynote: Open-source Multimodal AI in the Wild
 32mBuilding LLM Voice Bots with Open Source Tools
 10mBuilding Conversational AI Agents at Scale
 15mMulti-Modal AI Optimization: Combining Text, Vision, and Speech Efficiently