Minimize Risks and Accelerate MLOps with Model Performance Monitoring and Explainability

summary
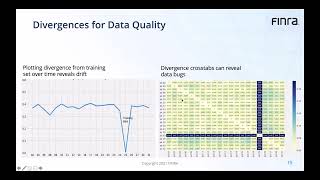
Fiddler ships a model performance management system that compares production and training distributions using Jensen‑Shannon divergence to flag prediction drift (examples show drift rising to ~0.25), attributes drift to individual features so teams know which feature caused the change, and tracks data quality (missing values, type/schema mismatches). It computes Shapley values decoupled from reference samples to give multiple attributions, supports bias checks across protected groups, and enables Challenger vs champion comparison and PyTorch explainability via Captum.
AI-written summary · about
chapters (15)
- 0:00Fiddler.ai introduction
- 1:10Challenges in operationalizing machine learning models
- 3:15Model drift risks
- 5:22Model Performance Management
- 6:24Detecting drift with distributions
- 7:27Concept drift impact
- 8:30Retrain or ignore drift
- 9:12Data pipeline monitoring
- 10:56Data quality for models
- 11:38Monitoring AI bias
- 12:21Explaining models with SHAP
- 14:06SHAP in ML theory
- 15:30Holistic model explanations
- 16:33Building MPM system
- 17:58Improving model quality
related talks
 45mExplainable Monitoring for Successful AI Deployments
 19mModel Performance Monitoring - A Practitioner's Perspective
 16mMLOps — Understanding and Fighting Model Degradation in Production
 13mHuman-in-the-Loop MLOps: Boost Model Performance by 40%
 12mModel Monitoring: Detecting and Analyzing Data Issues
 36mThe ML Monitoring Flow for Models Deployed to Production
 42mTesting Machine Learning Modules in Production
 15mOperationalizing Predictive Analytics in Education